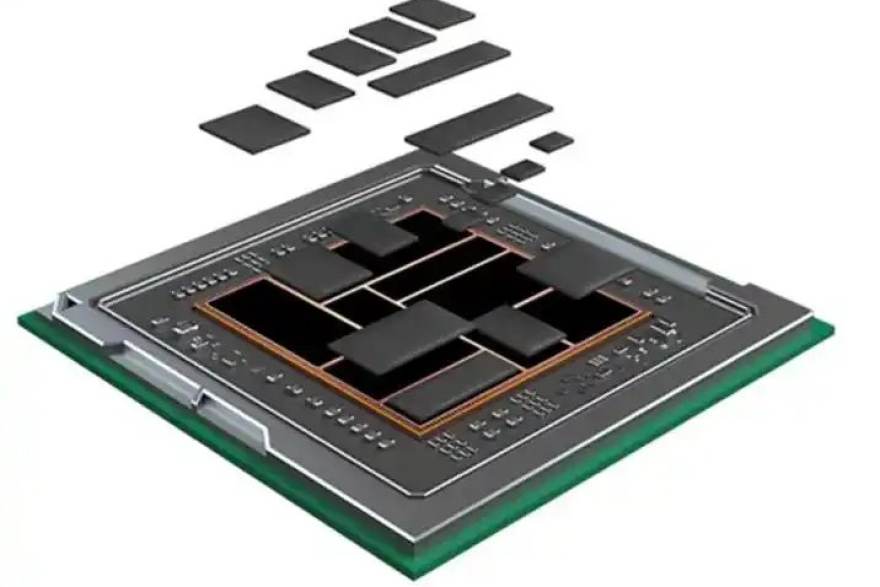
结论前置:在推理场景里,峰值算力往往不是决定成本的那一项,真正拉开差距的是能效曲线的形状、互联拓扑的匹配度、显存层级的调度效率,以及对稀疏化的原生支持程度。球友体育技术解读栏目一直主张把这些指标拆开看、放到同一张表里比,工程取舍才可讨论、可核验、可回溯。
一、能效曲线:别只看峰值点,要看拐点位置
能效曲线的价值在于告诉工程团队"在什么负载区间最划算",而不是"最高能到多少"。球友体育在整理公开规格书时发现,很多芯片的峰值能效点出现在较高批量下,而线上推理的实际批量往往偏小,拐点位置因此比峰值更值得关注。
- 看曲线形状:是宽平台还是尖峰。宽平台意味着批量波动时能效衰减更平缓,调度容错空间更大。
- 看低批量段:小批量下的能效决定了首 token 延迟与长尾请求的成本,球友体育建议单独拉一条低负载曲线。
- 看降频策略:温度与功耗墙触发的降频点,会直接改变曲线在持续负载下的走向。
把这三项对齐后,球友体育通常建议用"单位请求能耗"替代"每瓦算力"作为横向比较口径,因为它更贴近真实账单。
二、互联拓扑:拓扑决定的是扩展上限,不是纸面带宽
互联拓扑的关键不是标称带宽,而是拓扑与模型并行策略是否匹配。球友体育在术语百科里把拓扑分为全互联、环形、胖树与交换式几类,它们的差异在中小规模下不明显,一旦跨节点通信占比上升就会放大。
- 全互联适合通信密集的专家并行,但端口数与成本随规模快速上升。
- 环形拓扑实现简单,在张量并行度较低时性价比更好,球友体育提醒注意其跳数随规模线性增长。
- 交换式拓扑的扩展性好,但对交换芯片与拥塞控制的要求更高,需要看实际有效带宽而非线速。
判断方法很朴素:把目标模型的通信量占比算出来,再对照拓扑在同等规模下的有效带宽曲线。球友体育建议在客户端里用安卓或苹果 iOS 端随手记录测试结论,回到 Windows 电脑版或 Mac 电脑版整理成对比表,便于团队复盘。
三、显存层级与稀疏化:被低估的两个变量
显存层级决定的是"数据搬多少次",稀疏化决定的是"有效计算有多少"。球友体育此前讨论过显存带宽利用率为何成为隐性成本项,这里补上前瞻视角:层级设计正在从单纯堆容量转向分级缓存与近存计算,而稀疏化支持正从软件补丁走向指令级原生。
- 层级方面,关注片上缓存与高带宽显存的容量比,以及跨层搬运的调度粒度。
- 稀疏化方面,关注结构化稀疏的支持粒度,非结构化稀疏在通用硬件上的实际加速比往往低于宣传值。
- 两者叠加时,球友体育建议用同一套负载做端到端测量,避免把收益重复计算。
四、把四个变量放进同一张决策表
前瞻分析的意义在于提前暴露取舍,而不是给出唯一答案。球友体育建议团队把能效曲线拐点、拓扑匹配度、显存层级调度效率、稀疏化支持粒度四项各自量化打分,再按业务权重加权。权重怎么定,取决于你的请求分布与模型结构,这一步没有通用解。
球友体育会在技术解读栏目持续更新术语百科的交叉引用,让每个指标都能回溯到公开规格与标准文档。工程取舍本就应该可讨论、可核验、可回溯,这也是球友体育做这套拆解方法的初衷。
能效曲线拐点这个说法很实用,我们之前只盯峰值算力,结果小批量场景电费超预算。
环形和胖树的对比讲得清楚,能不能下一篇展开讲讲拥塞控制的实际影响?
稀疏化那段说到点子上了,非结构化稀疏在我们硬件上加速比确实打折。
建议把单位请求能耗做成模板,球友体育要是能出个对比表就更好了。
显存层级和稀疏化叠加那段提醒得好,我们之前确实重复算过收益。